So Sánh Các Kiểu Auto Caption Khi Training LoRA: Hướng Dẫn Tối Ưu Hóa Chất Lượng Hình Ảnh

So Sánh Các Kiểu Auto Caption Khi Training LoRA: Hướng Dẫn Tối Ưu Hóa Chất Lượng Hình Ảnh
Trong lĩnh vực trí tuệ nhân tạo tạo sinh hình ảnh, việc training các mô hình LoRA (Low-Rank Adaptation) để tùy biến phong cách hoặc đối tượng đã trở nên vô cùng phổ biến. Một trong những yếu tố cốt lõi quyết định sự thành công của một LoRA chính là chất lượng của “caption” – những dòng mô tả đi kèm với dữ liệu hình ảnh được training.
Tài liệu này sẽ đi sâu vào việc so sánh các phương pháp tạo caption khác nhau, từ đó đưa ra những đánh giá và khuyến nghị giúp bạn tạo ra những LoRA chất lượng nhất.
Bối Cảnh Training
Để đảm bảo tính nhất quán, các thử nghiệm được thực hiện với bộ thông số cài đặt chung như sau:
- Engine: kohya
- Resolution: 1024
- Network Dimension: 2
- Network Alpha: 16
- Số lần lặp (numRepeats): 6
- Số epochs: 5
- Optimizer: AdamWBBit
- Learning Rate Scheduler: cosine_with_restarts
1. Không Sử Dụng Caption và Từ Khóa Kích Hoạt
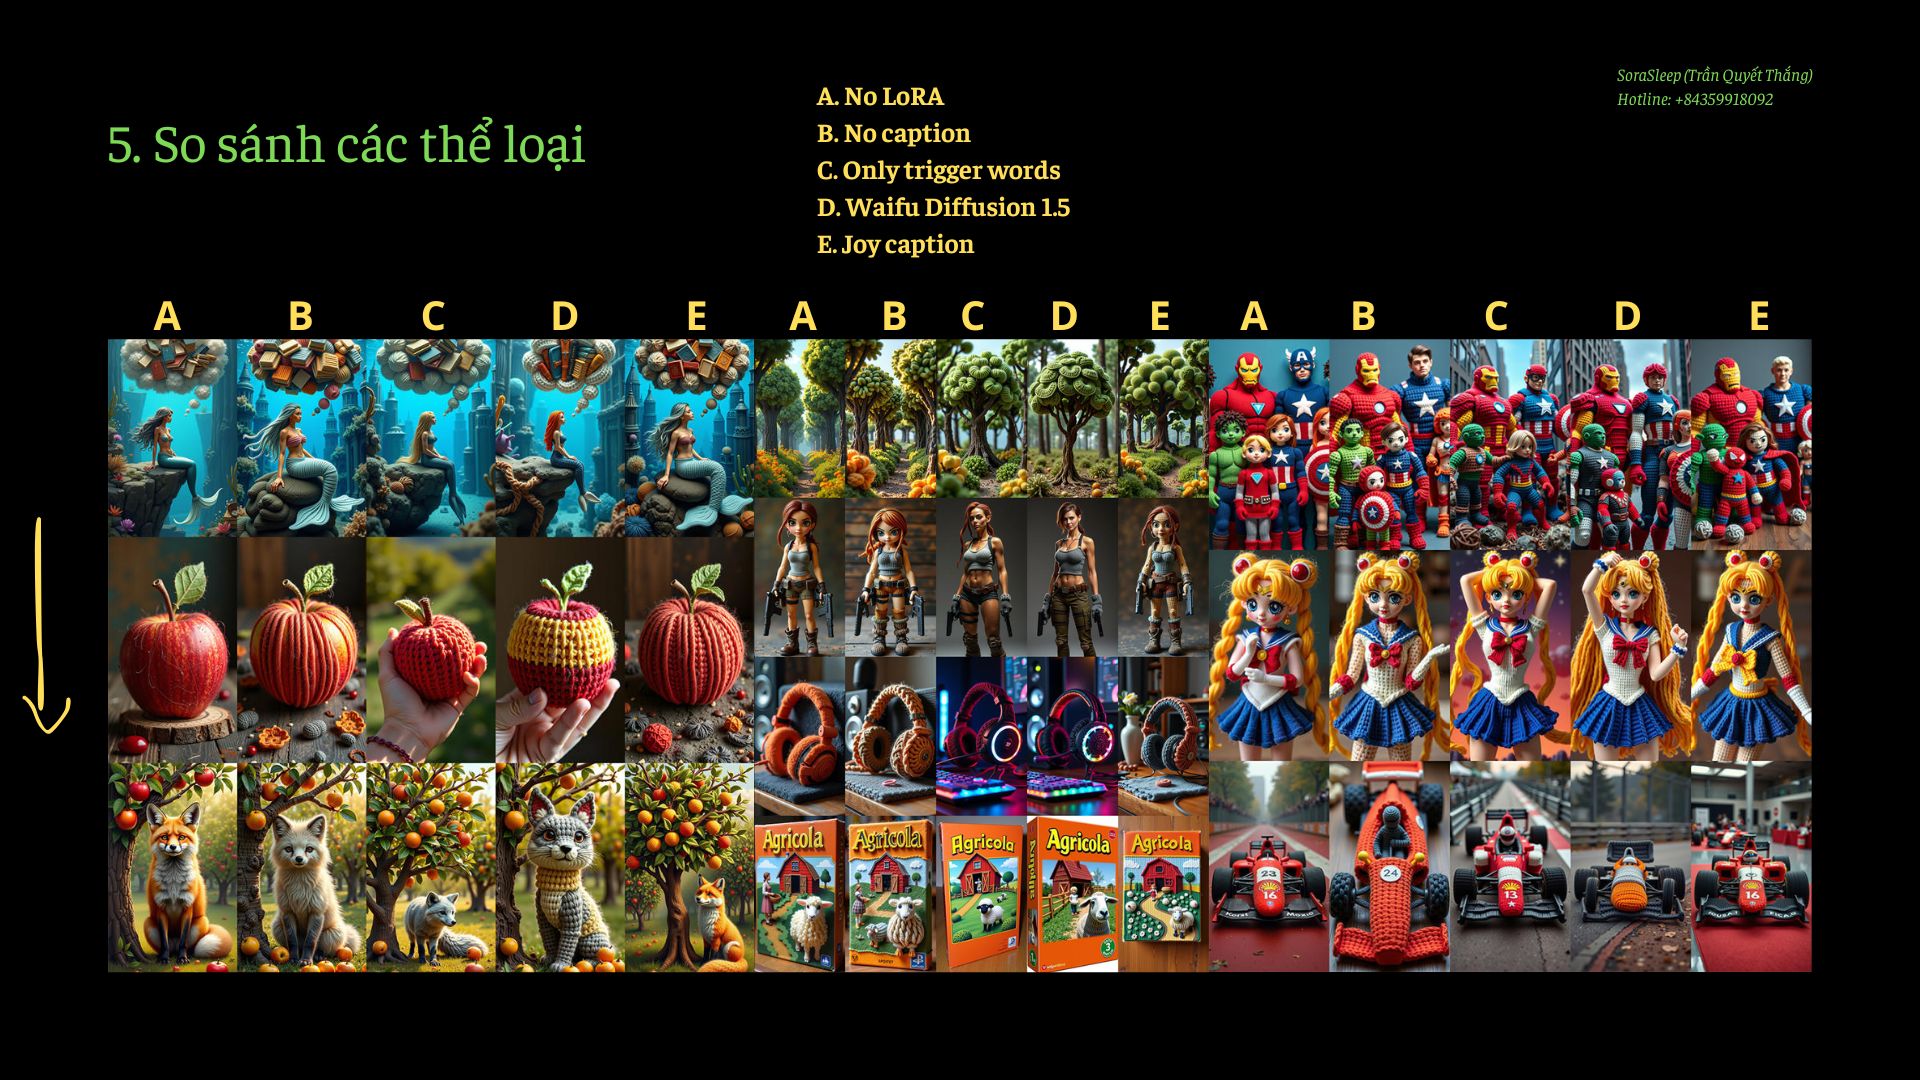
Đây là phương pháp cơ bản nhất, trong đó LoRA được training trực tiếp trên bộ dữ liệu hình ảnh mà không có bất kỳ mô tả văn bản nào.
Đánh giá:
- Hạn chế: Khi không có LoRA, các mô hình nền tảng (base model) có thể không hiểu được phong cách đặc trưng mà bạn mong muốn. Việc training LoRA mà bỏ qua caption và từ khóa kích hoạt đồng nghĩa với việc bạn đã loại bỏ một phần dữ liệu quan trọng để mô tả phong cách.
- Lưu ý: Phương pháp này có thể tạm chấp nhận được với các LoRA có phong cách đơn giản, dễ nhận biết. Tuy nhiên, với những yêu cầu phức tạp hơn, chất lượng LoRA tạo ra sẽ rất thấp.
2. Chỉ Sử Dụng Từ Khóa Kích Hoạt (Trigger Word)
Với phương pháp này, mỗi hình ảnh trong bộ dữ liệu sẽ được gán một từ khóa duy nhất (ví dụ:
w00lywOrld).
Đánh giá:
- Trường hợp sử dụng: Phương pháp này chỉ thực sự hiệu quả khi bạn muốn training một vật thể hoặc một phong cách rất cụ thể và cố định. Ví dụ, bạn có thể training hình ảnh một cô gái đội nón lá với các góc chụp khác nhau chỉ bằng một từ khóa.
- Rủi ro: Không nên áp dụng cách này với một bộ dữ liệu (dataset) quá lớn và đa dạng. Mô hình có thể học “trộn lẫn” các chi tiết không liên quan với nhau, dẫn đến kết quả không như ý.
3. Sử Dụng Waifu Diffusion 1.4 (WD 1.4) Captions
Đây là một mô hình chuyên dụng để tạo caption, được training trên một bộ dữ liệu khổng lồ gồm hơn 5 triệu hình ảnh theo phong cách anime.
Đánh giá:
- Đặc điểm: Mô hình này có khả năng chuyển đổi hình ảnh anime thành các đoạn văn bản mô tả chi tiết (ví dụ:
1 girl, long hair, full body, black background, blue hair...). - Khuyến nghị: Đúng như tên gọi, WD 1.4 chỉ nên được ưu tiên sử dụng khi bạn training LoRA cho nhân vật hoặc phong cách anime. Đối với tất cả các trường hợp khác, các mô hình tạo caption tổng quát hơn như Joy Caption sẽ là lựa chọn tối ưu hơn.
4. Sử Dụng Joy Captions
Joy Captions là một mô hình tạo caption linh hoạt và được đánh giá rất cao ở thời điểm hiện tại cho hầu hết các loại hình ảnh.
Đánh giá:
- Ưu điểm vượt trội: Joy Captions được xem là mô hình tạo caption tốt nhất hiện nay cho mọi thể loại. Nó cho phép người dùng viết yêu cầu (prompt) để hướng dẫn mô hình mô tả hình ảnh theo ý muốn. Ví dụ, bạn có thể yêu cầu nó chỉ tập trung vào nhân vật và bỏ qua phần hậu cảnh.
- Tầm quan trọng: Đối với việc training một LoRA phức tạp, đòi hỏi độ chi tiết cao, thì caption chất lượng là yếu tố cực kỳ quan trọng.
- So sánh: Mặc dù có những mô hình khác tạo caption dạng đoạn văn như Blip, LLAVA, hay Florence, nhưng Joy Captions vẫn được đánh giá cao hơn về hiệu quả.
Tổng Kết và Khuyến Nghị Cuối Cùng
Dựa trên các so sánh và đánh giá chi tiết, tác giả đưa ra những khuyến nghị thực tiễn như sau:
- Đối với mô hình SD1.5: Nên sử dụng WD1.4 để tạo caption.
- Đối với mô hình SDXL: Nên sử dụng Joy Caption và giới hạn độ dài caption trong khoảng 70 từ.
- Đối với mô hình Pony: Sử dụng WD1.4 vẫn cho kết quả tốt.
- Đối với mô hình Flux: Ưu tiên hàng đầu là Joy Caption.
Việc lựa chọn phương pháp tạo caption phù hợp không chỉ giúp mô hình “hiểu” đúng ý đồ của bạn mà còn là chìa khóa để tạo ra những LoRA với chất lượng vượt trội và khả năng tùy biến cao.